Publicado em
9 MINUTOS DE LEITURA
Transcrição com Whisper e o limite de 30 segundos
Por:
Na transcrição com Whisper, o prompt inicial com o vocabulário esperado só vale para os primeiros 30 segundos do áudio quando a opção condition_on_previous_text está desligada. A Wama mediu isso em 147 vídeos em português: "Claude" saiu certo 14 vezes no começo dos vídeos e nenhuma vez depois dos 30 segundos.
Transcrever vídeo com IA virou etapa comum para quem transforma reunião, aula ou conteúdo de redes em texto pesquisável. O Whisper, modelo aberto de reconhecimento de fala da OpenAI, roda no próprio computador e entende bem o português. O ponto fraco está nas palavras que mais importam numa conversa sobre IA: nomes de ferramentas, empresas e siglas em inglês.
Em novembro de 2026, a Wama transcreveu 147 vídeos curtos sobre o dia a dia de uma agência de IA, somando 183,7 minutos de fala, num Mac e sem enviar o áudio para nenhum serviço externo. No caminho apareceu um problema de configuração que afeta qualquer empresa que transcreve fala técnica, e que virou um estudo com experimento controlado. O relatório técnico completo, com dados e scripts, está no Zenodo, com o DOI 10.5281/zenodo.24174768.
O que a Wama mediu em 147 vídeos
O material são 147 vídeos publicados entre janeiro e setembro de 2026 por um criador brasileiro que fala sobre a rotina de uma agência de IA. A mediana é de 69 segundos por vídeo. A transcrição usou o modelo whisper-large-v3-turbo, na versão para chips da Apple (mlx-whisper), com idioma fixado em português e um prompt inicial com 20 termos esperados, entre eles Claude, n8n e Anthropic.
O resultado se divide em dois grupos bem nítidos. Palavras que já circulam como português, como agente, automação, lead, WhatsApp, CRM e prompt, saíram certas em 261 de 261 ocorrências. As marcas em inglês listadas no prompt acertaram só 14 de 54 vezes, ou 26%. A velocidade não foi problema: os 147 vídeos levaram 8,3 minutos, cerca de 2,6 segundos de processamento por minuto de fala.
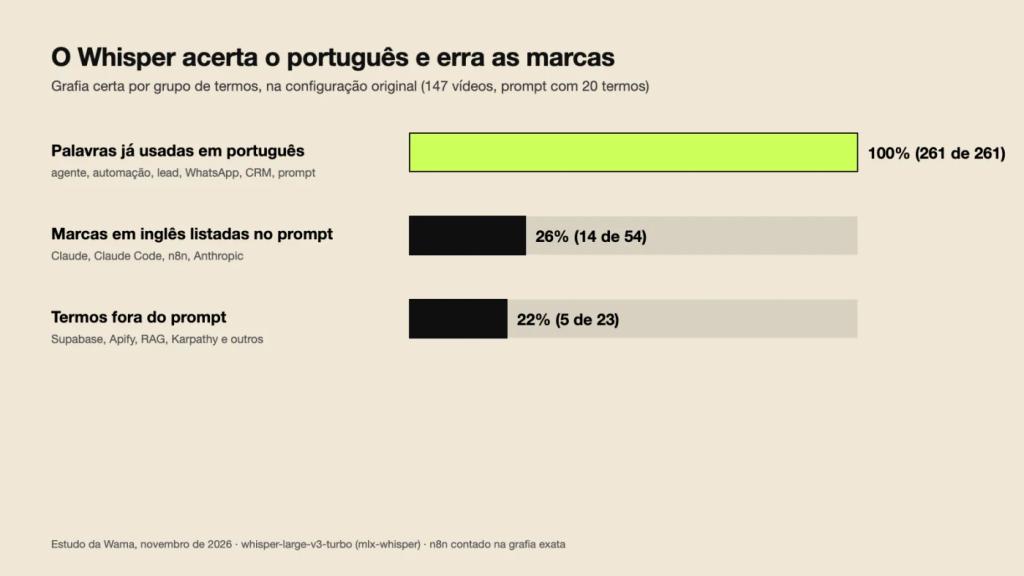
Na Wama, a IA entra no código e na automação com o Claude Code, como contamos no texto sobre Claude Code no desenvolvimento. Por isso o erro mais frequente do estudo chamou atenção: das 41 vezes em que o nome Claude foi dito, 27 viraram "Cloud", "Cloud Code" ou "Cláudio".
| Termo dito | Certo | Errado | Como o Whisper escreveu |
|---|---|---|---|
| agente, automação, lead, WhatsApp, CRM, prompt | 261 | 0 | sempre certo |
| Claude | 9 | 15 | Cloud, Cláudio |
| Claude Code | 5 | 12 | Cloud Code |
| n8n | 0 | 11 | N2N, E2N, N820, Neto N, N8N |
| Anthropic | 0 | 2 | Antropi, Antropic |
Por que o Whisper erra nomes de ferramentas de IA?
O Whisper erra nomes de ferramentas de IA porque escreve a sequência de palavras mais provável para o som que ouviu, e um nome em inglês dito com sotaque brasileiro costuma soar como outra palavra que o modelo conhece melhor. No estudo da Wama, os erros caíram em três tipos.
Troca fonética. Supabase virou "Superbase", Lovable virou "Lovago", Apify virou "AppFi" e o nome do pesquisador Andrej Karpathy virou "Carpatti".
Troca por palavra conhecida. O aplicativo de ditado Wispr Flow virou "Whisper Flow", o nome do próprio modelo. Cal.com virou "call.com" e cold outreach virou "Code Outreach".
Sigla perdida. "Agente de IA" virou "agente de A" ou "agente de ar" 21 vezes, em 13 vídeos diferentes.
O padrão é útil para quem revisa transcrições: o erro quase nunca é aleatório. Ele se repete com a mesma grafia, o que permite corrigir com um dicionário depois, uma etapa simples de automação de processos com IA descrita na seção de método.
O initial_prompt do Whisper funciona?
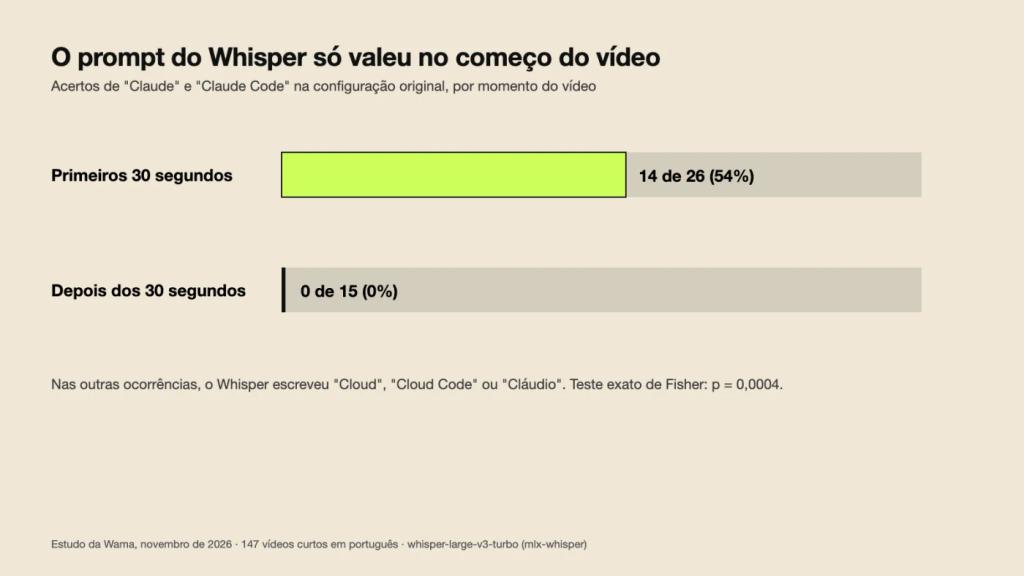
O initial_prompt do Whisper funciona, mas só no começo do áudio quando condition_on_previous_text está desligado. O modelo processa o som em janelas de 30 segundos e, nessa configuração, apaga o contexto ao fim de cada janela, levando o prompt junto. No estudo da Wama, Claude acertou 14 de 26 vezes antes dos 30 segundos e 0 de 15 depois.
A diferença é estatisticamente forte (teste exato de Fisher, p = 0,0004), e nos termos que não estavam no prompt a taxa de acerto não muda entre o começo e o resto do vídeo. A explicação está no próprio código da biblioteca, que zera o prompt junto com o contexto. Quem acompanha o Whisper já tinha apontado o comportamento: uma proposta de 2024 no repositório da OpenAI parte da observação de que o prompt inicial só vale para a primeira janela.
A documentação de fala para texto da OpenAI, consultada em novembro de 2026, recomenda o prompt justamente para nomes de produtos, termos técnicos e siglas. O que ela não deixa claro é que, com a configuração usada para evitar repetições, o prompt cobre só a abertura. Nos vídeos do estudo, com mediana de 69 segundos, a maior parte da fala ficou sem ele.
Qual configuração acertou mais?
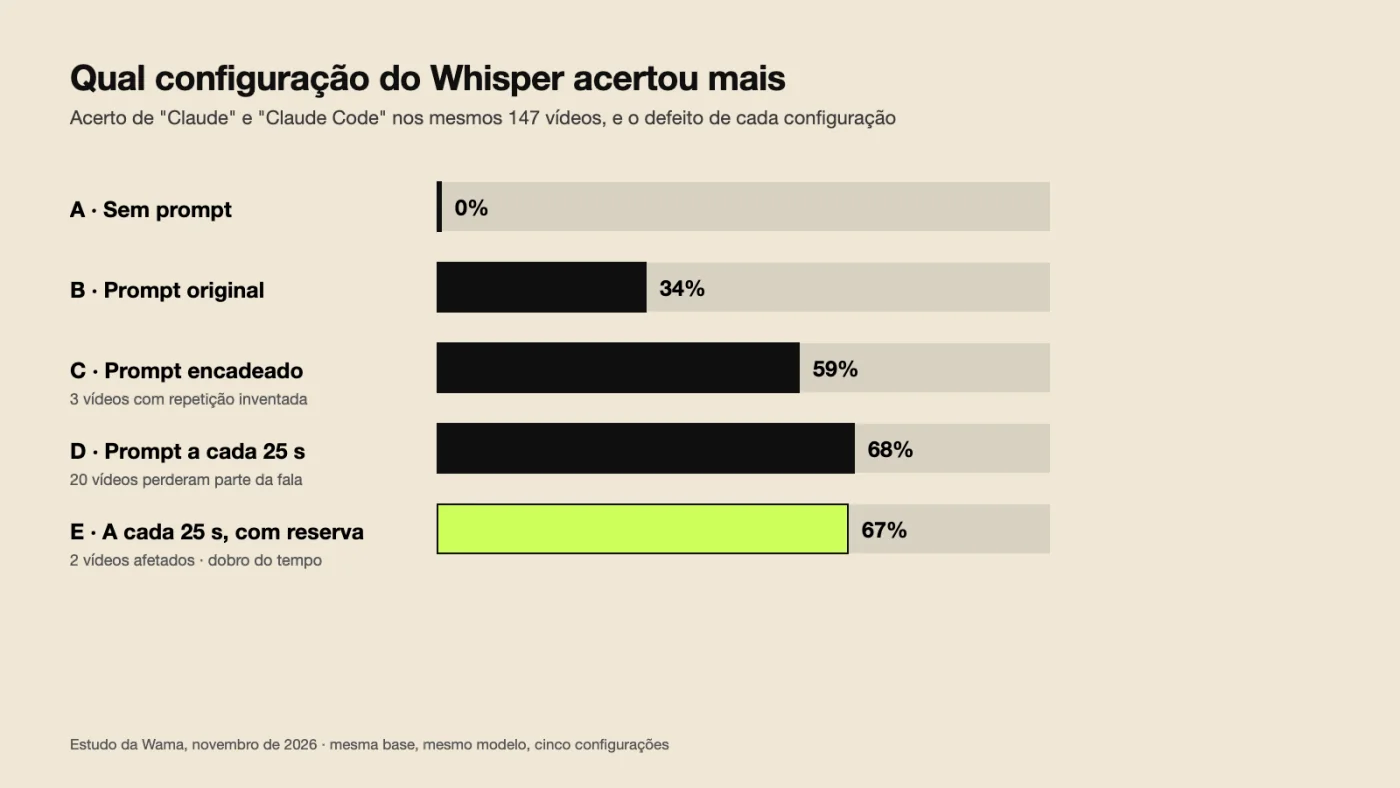
A configuração que acertou mais nomes sem perder fala foi transcrever o áudio em trechos de 25 segundos, com o prompt em cada trecho, e comparar cada trecho com uma versão sem prompt. Ela acertou 67% das ocorrências de Claude, contra 34% da configuração original, sem repetições inventadas e com só 2 vídeos afetados por perda de fala.
Para chegar a isso, a Wama retranscreveu os mesmos 147 vídeos em cinco configurações, e a original se reproduziu exatamente.
| Configuração | Acerto em Claude | Defeito encontrado | Tempo para 147 vídeos |
|---|---|---|---|
| A. Sem prompt | 0% | nenhum além dos erros | 6,6 min |
| B. Prompt original | 34% | prompt só nos primeiros 30 s | 6,7 min |
| C. Prompt encadeado | 59% | 3 vídeos com repetição inventada | 8,1 min |
| D. Prompt a cada 25 s | 68% | 20 vídeos perderam parte da fala | 7,3 min |
| E. A cada 25 s, com reserva | 67% | 2 vídeos com perda pequena | 14,8 min |
Cada solução simples tem um custo escondido. Encadear o contexto fez o modelo repetir "Prego. Prego. Prego." 41 vezes num vídeo. Repetir o prompt em cada trecho fez o modelo, em alguns trechos, pular direto para a última frase: o mesmo trecho rendeu 101 palavras sem prompt e 4 com prompt. A configuração E existe para pegar esse segundo defeito, ao custo de dobrar o tempo de processamento.
Como transcrever vídeos com termos técnicos sem perder fala?
O método que saiu do estudo cabe em cinco passos, e nenhum depende de serviço pago. Na Wama, todo resultado de IA passa por leitura humana antes de ir ao cliente, e a transcrição entra na mesma regra: o passo 3 existe porque a falha mais perigosa não gera aviso, o texto simplesmente sai mais curto.
Confira a trilha de áudio de cada arquivo antes de transcrever. No estudo, 18 dos 147 vídeos baixados (12%) vieram sem som, porque a plataforma entrega áudio e imagem separados.
Faça o prompt valer no vídeo inteiro. Corte em trechos de até 30 segundos, transcreva cada um com e sem prompt e fique com a versão sem prompt quando a outra sair com menos de 70% das palavras.
Procure buracos. Intervalo maior que 4 segundos entre segmentos, ou trecho com bem menos palavras por segundo que o resto, indica fala pulada. Retranscreva só esse trecho.
Mantenha um dicionário de correção. Nomes que nenhum prompt resolve, como n8n, são trocados depois da transcrição: "N2N" e "Neto N" viram n8n.
Meça no vídeo inteiro. Quem confere só o começo das transcrições acha que o prompt funciona, porque é ali que ele vale.
Para decidir quais conversas valem ser transcritas, o mapa de onde usar IA na empresa é um bom começo.
Erros comuns na transcrição com Whisper
Confiar no prompt sem medir. A lista de termos ajuda, mas não obriga o modelo. No estudo, n8n não saiu certo em nenhuma das cinco configurações, nem com o termo repetido a cada trecho.
Ligar o contexto encadeado e não procurar repetição. A opção melhora a grafia, mas pode produzir frases repetidas que ninguém disse.
Cortar o áudio em trechos sem reserva. O prompt em cada trecho dobra o acerto e, sem a comparação com a versão sem prompt, apaga fala em 14% dos vídeos.
O que isso muda para bases de conhecimento e agentes
Quando transcrições alimentam uma base de conhecimento, um nome de ferramenta grafado errado deixa de ser detalhe estético: o trecho some da busca. Uma pergunta sobre "Claude Code" não encontra um texto que diz "Cloud Code", e uma busca por "n8n" não encontra "Neto N".
Nesse ponto, a transcrição vira parte do segundo cérebro da empresa. Na leitura da Wama, a transcrição que alimenta um agente de IA com base de conhecimento precisa do mesmo controle de qualidade de qualquer outro documento da base: método registrado, conferência por amostra e dicionário de correção mantido por alguém.
Perguntas frequentes
O Whisper funciona bem em português?
Funciona bem na fala comum. No estudo da Wama com 147 vídeos, palavras como agente, automação, lead e WhatsApp saíram certas em 261 de 261 ocorrências. A dificuldade está nos nomes em inglês e nas siglas, que o modelo troca por palavras parecidas. Para esses, vale combinar prompt por trecho com um dicionário de correção.
Dá para rodar o Whisper no Mac sem internet?
Dá. O estudo usou o mlx-whisper num Apple M4 Pro com 24 GB de memória: 183,7 minutos de fala foram transcritos em 8,3 minutos, cerca de 2,6 segundos por minuto de áudio. Depois de baixado o modelo, o áudio não sai do computador, o que ajuda quando a gravação tem informação interna.
O que é condition_on_previous_text no Whisper?
É a opção que passa o texto já transcrito como contexto para a próxima janela de 30 segundos. Ligada, ela mantém o vocabulário ao longo do vídeo, mas pode gerar repetições inventadas: no estudo, 3 de 147 vídeos. Desligada, evita as repetições, mas o prompt inicial deixa de valer depois da primeira janela.
Como corrigir nomes que o Whisper sempre erra?
Com um dicionário de correção aplicado depois da transcrição, que troca cada grafia errada conhecida pela certa, como "Cloud Code" por Claude Code. Funciona porque o erro se repete com a mesma grafia. O cuidado é conferir o contexto antes de incluir uma troca: no estudo, todas as 26 ocorrências de "Cloud" se referiam ao Claude.
Onde estão os dados do estudo?
No relatório técnico depositado no Zenodo, com as planilhas de cada ocorrência, os tempos por vídeo, o resultado das cinco configurações e os scripts para refazer a medição, pelo DOI 10.5281/zenodo.24174768. Os vídeos e as transcrições completas não são redistribuídos, porque o conteúdo é de terceiro.
Se a sua empresa transforma reuniões, vídeos ou atendimentos em texto para alimentar uma base ou um agente, a transcrição é a primeira peça a medir, antes da ferramenta de busca. Para desenhar esse fluxo com controle de qualidade desde o começo, converse com a Wama.