Publicado el
26 MIN DE LECTURA
Video publicitario con IA: paso a paso y costos

Por:
Un video publicitario con IA sale de una cadena de cinco herramientas: modelo 3D del producto, referencia visual, imagen base generada y corregida en ChatGPT, animación en Seedance 2.5 dentro de Higgsfield y upscale a 4K. En este artículo muestro el paso a paso del video Stanley Time, con prompts, capturas y el costo de cada etapa.
El video se publicó en mi perfil de Instagram, @henriquesaas, y este es el primer artículo de una serie que abre los prompts detrás de cada publicación. Es una pieza de estudio, sin vínculo con la marca Stanley. El objetivo era medir hasta dónde puede llevar un comercial una sola persona, sin set, sin modelo y sin productora.
Antes de la lista de pasos, una advertencia honesta: ninguna etapa salió a la primera. El vaso nació pequeño, la modelo ganó piernas de más y hubo una toma de video descartada. El proceso de abajo incluye los errores, porque son la parte que nadie muestra y la que más enseña.
¿Qué es un video publicitario con IA y qué exige?
Un video publicitario con IA es una pieza de comunicación en la que producto, escenario, modelo y movimiento son generados o reconstruidos por modelos de inteligencia artificial, a partir de referencias y prompts escritos por una persona. Exige lo mismo que un comercial tradicional antes de la cámara: dirección de arte, decisión de encuadre y criterio para aprobar o descartar. Lo que cambia es el costo de cada intento.
En el caso de Stanley Time, la cadena fue esta, en orden:
Modelo 3D del vaso en Blender, construido por GPT-6 Astra a partir de un prompt.
Búsqueda en Pinterest de una referencia de composición y tipografía.
Imagen base generada en ChatGPT y corregida en rondas hasta cerrar color, escala y anatomía.
Animación de la imagen en Seedance 2.5, dentro de Higgsfield, con un prompt largo de física y cámara.
Upscale a 4K con Topaz Video, también en Higgsfield.
Cada etapa tiene una sección abajo, con la captura de lo que pasó y el prompt que generó ese resultado. Al final, una tabla resume lo que consumió cada herramienta.
Paso 1: el producto en 3D en Blender con GPT-6 Astra
El vaso empezó como objeto 3D, no como foto. La razón es control: con el producto modelado, el color, el asa, la tapa y el popote quedan fijos, y toda imagen generada después tiene una referencia sólida que respetar. Una foto de banco de imágenes no da ese control, y el color exacto tenía que ser una decisión mía, no un hallazgo.
Quien construyó el modelo fue GPT-6 Astra, el modelo de OpenAI lanzado el 3 de septiembre de 2026 que, según el análisis de Decrypt publicado el 6 de septiembre de 2026, opera aplicaciones de escritorio controlando el mouse y el teclado en lugar de devolver una lista de instrucciones. En la práctica, recibió el prompt y armó el vaso dentro de Blender: geometría, materiales y una escena editable. Yo revisé proporciones y ajusté el render.
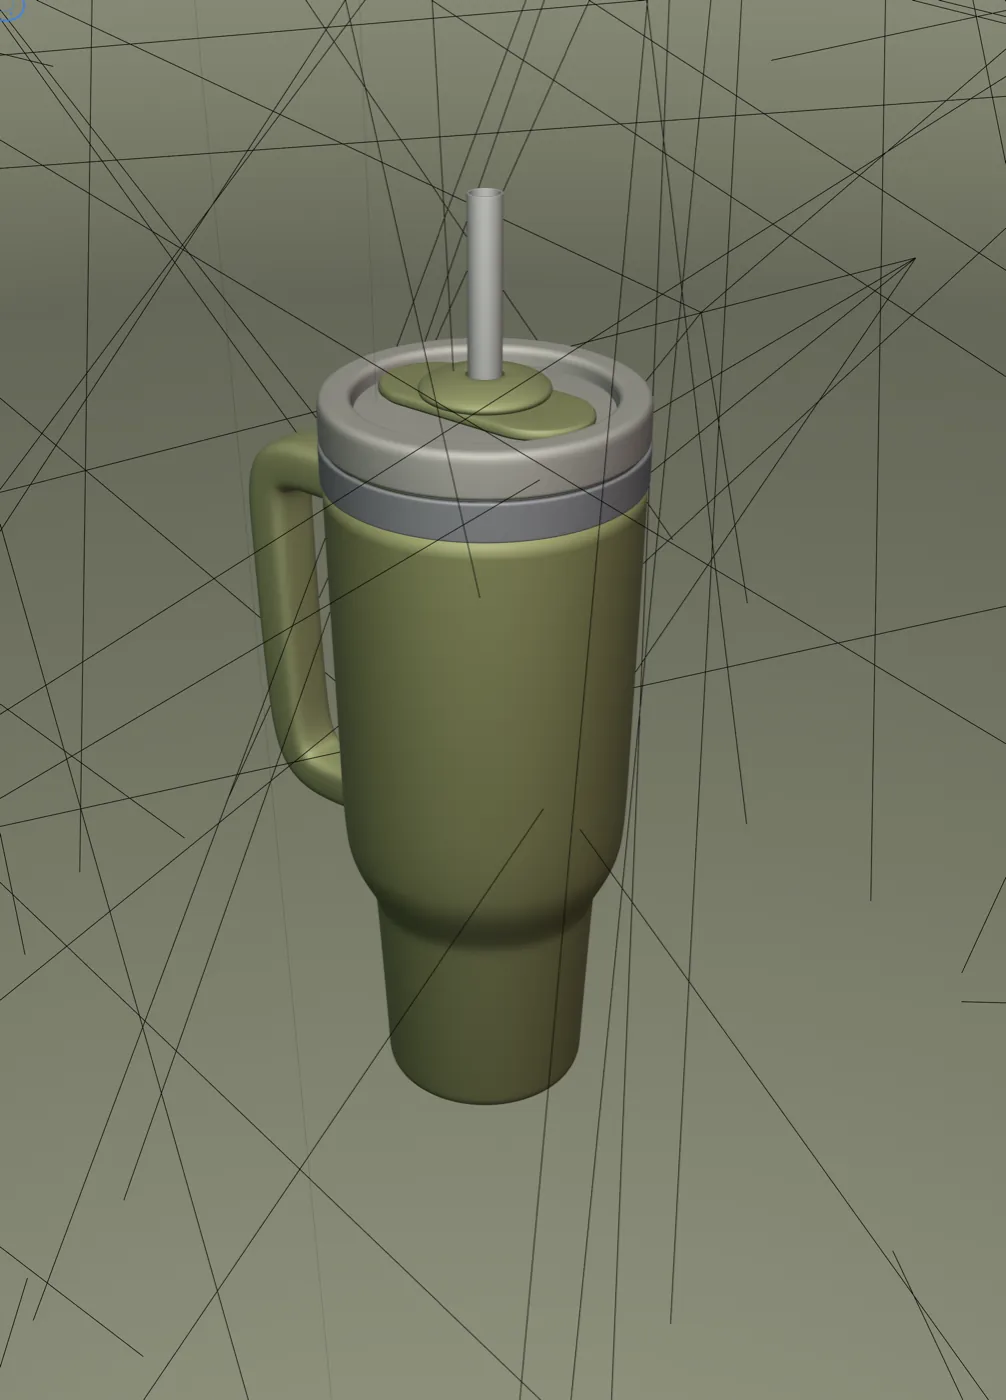
El texto que guía esta etapa es el prompt de Astra para Blender, que Wama está liberando gratis en un artículo propio. Costo de esta etapa: cerca del 11% de la cuota mensual de mi plan Pro de ChatGPT. Es, de lejos, la etapa más cara en consumo de modelo, y tiene sentido: son muchas idas y vueltas de un agente operando software, no una respuesta de texto.
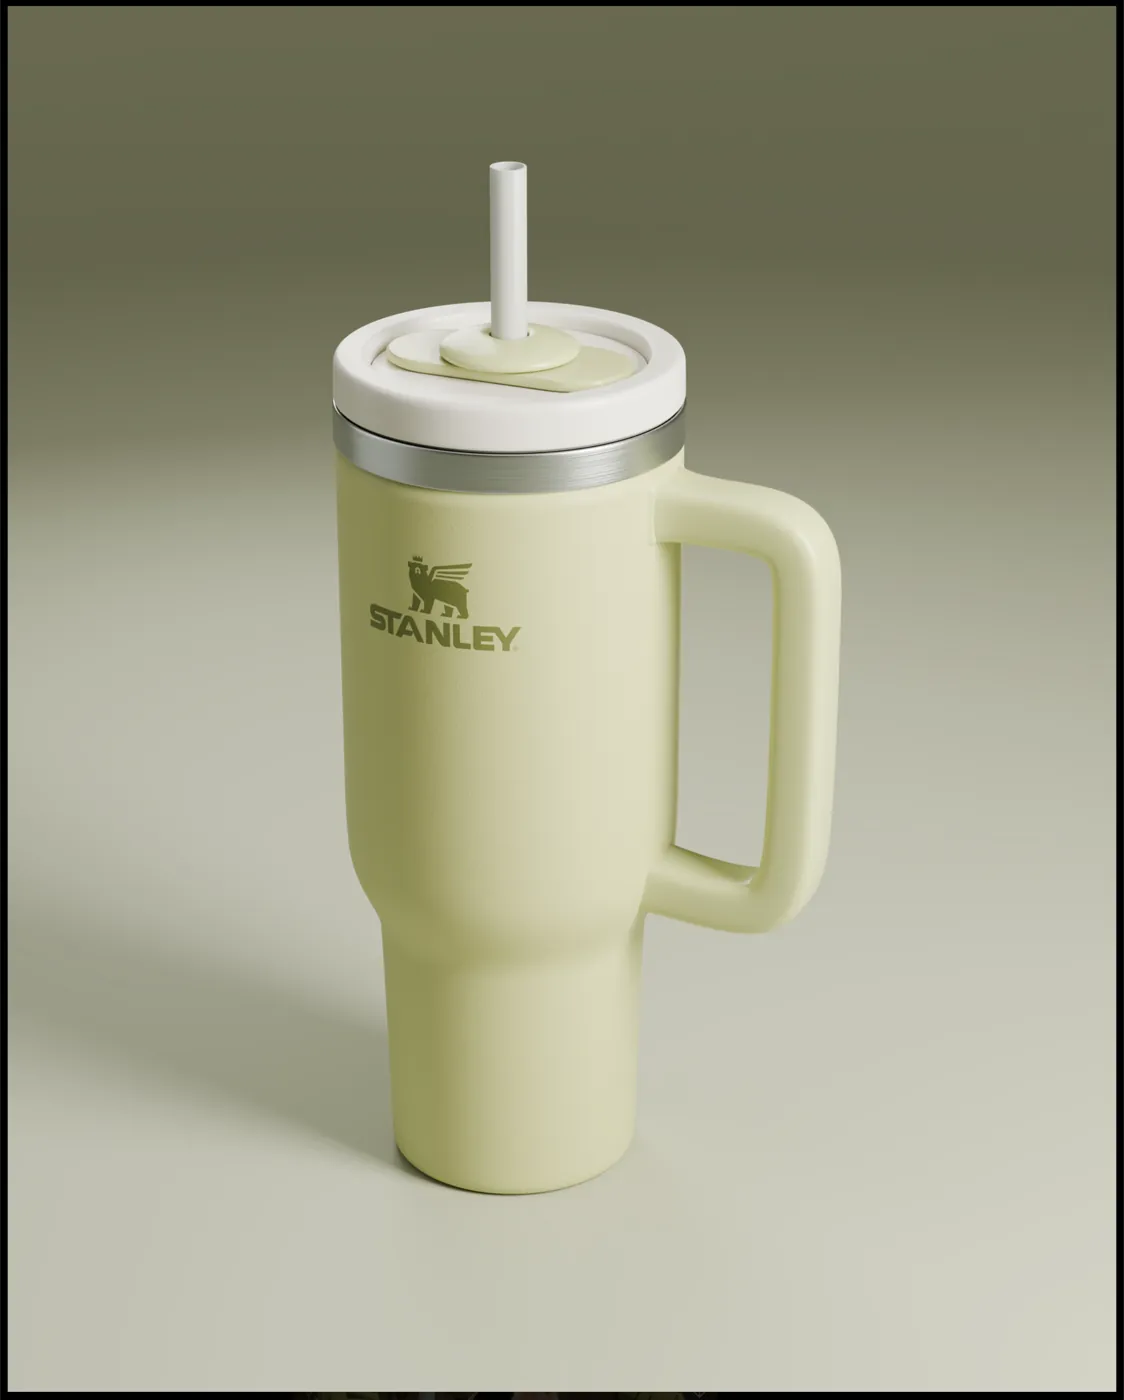
El render final salió con el logotipo aplicado y el color pistache que se volvió la paleta de todo lo que vino después. Guardé más de una vista del vaso; entran como referencia en las etapas siguientes.
Paso 2: la referencia antes de cualquier prompt
Un prompt sin referencia es lotería. Antes de pedir cualquier imagen, fui a Pinterest a buscar una composición que ya resolviera el problema de dirección de arte: persona en primer plano, producto en la mano, tipografía 3D aterciopelada orbitando el cuerpo. Encontré una pieza firmada por @atachkina, del estudio Design Touch, con la frase Summer Time en letras afelpadas sobre una cancha de tenis.
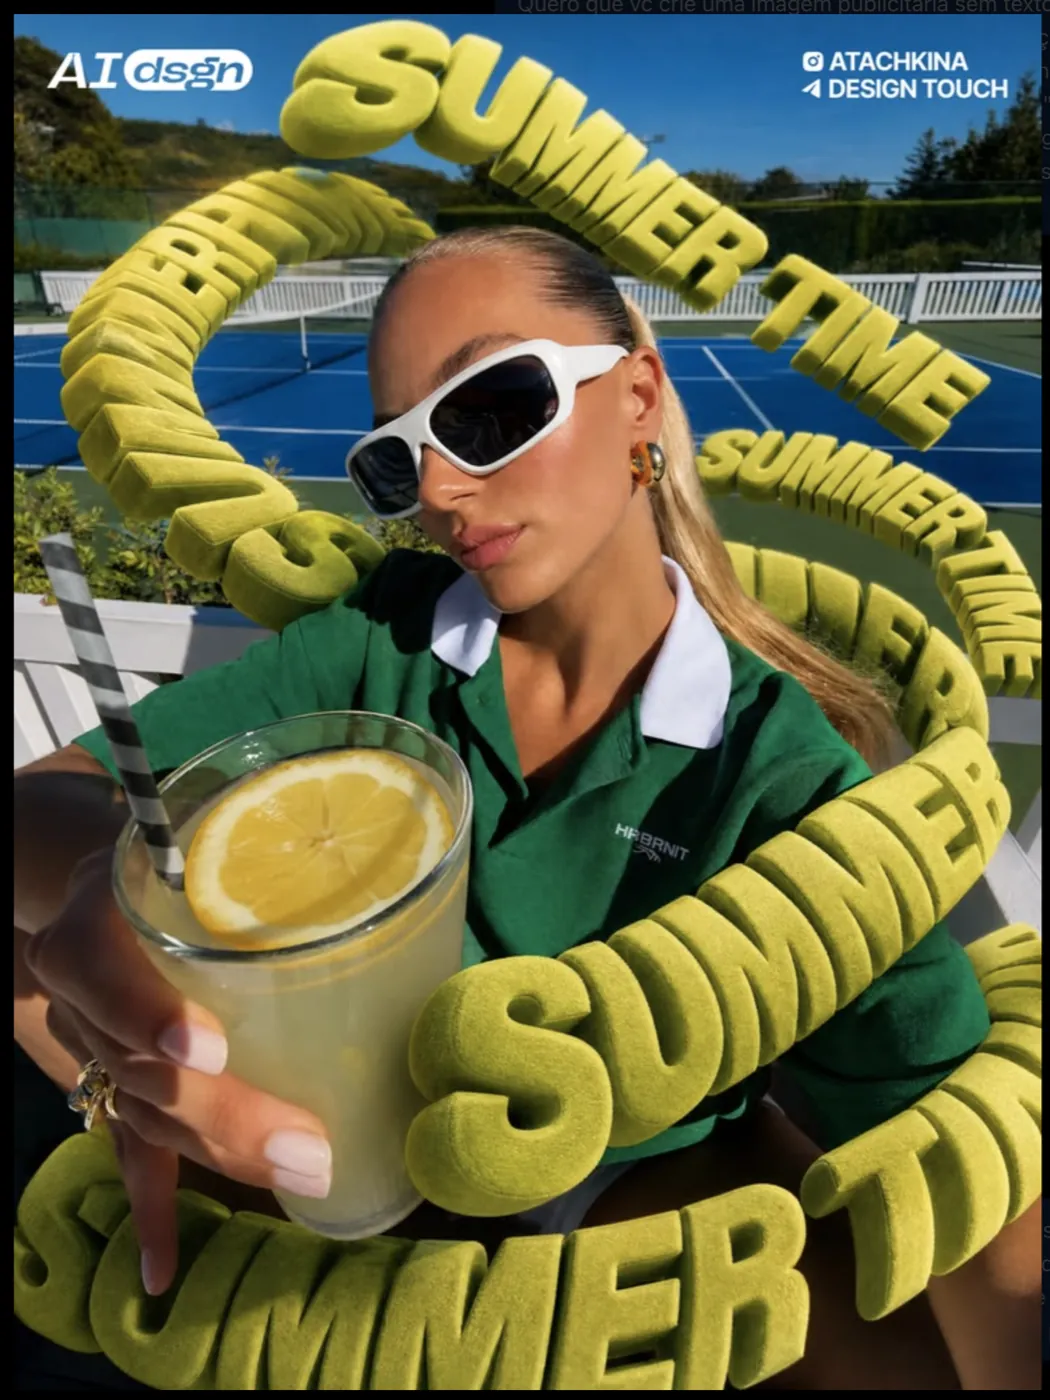
La referencia no se copia; es la regla de medir. Decide la pose, el lente, la posición de las letras y el clima. Esa es la decisión de diseño que precede a la herramienta: sin ella, cada ronda de generación tira para un lado, y gastas créditos buscando una dirección que debería estar definida antes de abrir cualquier modelo.
Paso 3: ¿cómo generar la imagen base en ChatGPT?
La imagen base sale del generador de imágenes de ChatGPT, que recibe tres cosas: la referencia de Pinterest, los renders del vaso y un prompt en portugués que describe la escena y fija lo que no puede cambiar. La primera versión rara vez es la final; las rondas siguientes corrigen escala, color y anatomía, de preferencia una corrección a la vez.
Primera ronda: la escena entera en un prompt
Este fue el primer prompt, pegado sin editar:
Quiero que crees una imagen publicitaria sin textos, solo con la frase 3d estilizada, de una persona en la misma posición que esta mujer, sosteniendo el vaso verde de Stanley, mostrando la marca a la cámara y esta fuente 3d alrededor de ella con la frase "Stanley Time" con exactamente el mismo efecto y textura de la fuente de la imagen original, los colores de la ropa y de los lentes deben estar muy cerca del verde pistache de la botella
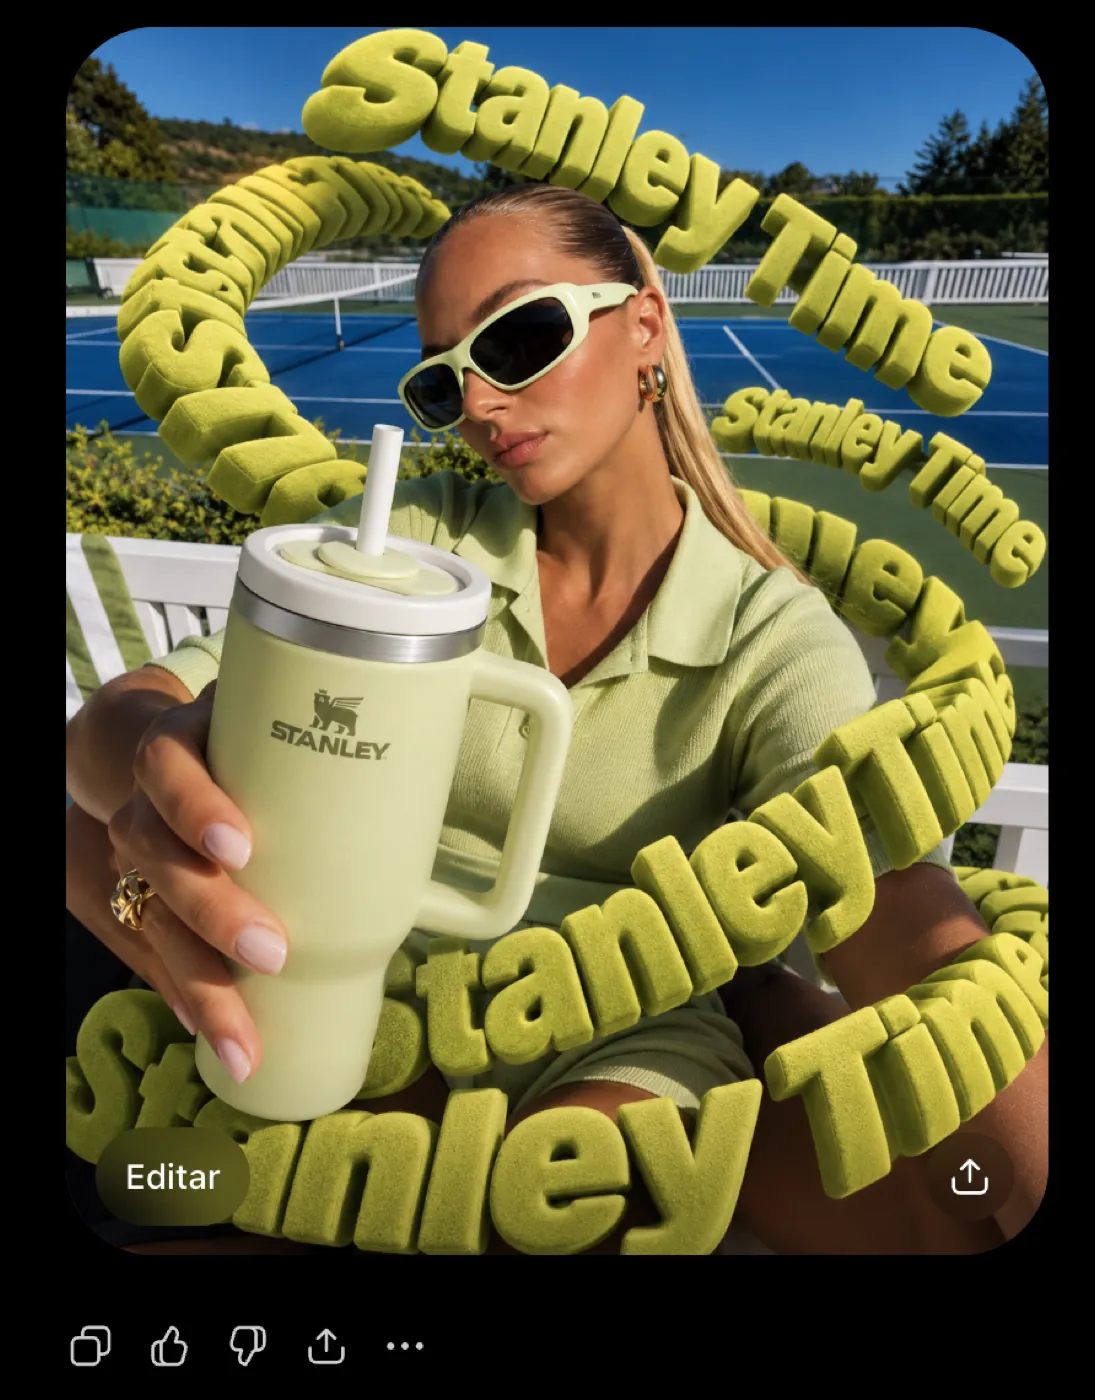
La primera versión acertó la pose y la tipografía y falló en el resto: cancha azul, vaso pequeño, letras en mayúsculas y minúsculas mezcladas.
Segunda ronda: escala, fondo y paleta
El segundo prompt corrige tres cosas de una vez, y dos de ellas salen bien:
Las fuentes deben ser todas en mayúsculas, el vaso de stanley mide 28 cm y debe ser más grande de lo que lo pusiste. cambia el color del fondo por una cancha de tenis de arcilla y un poco más de verde al fondo, quiero que la imagen sea casi en tonos monocromáticos pistache (90%)
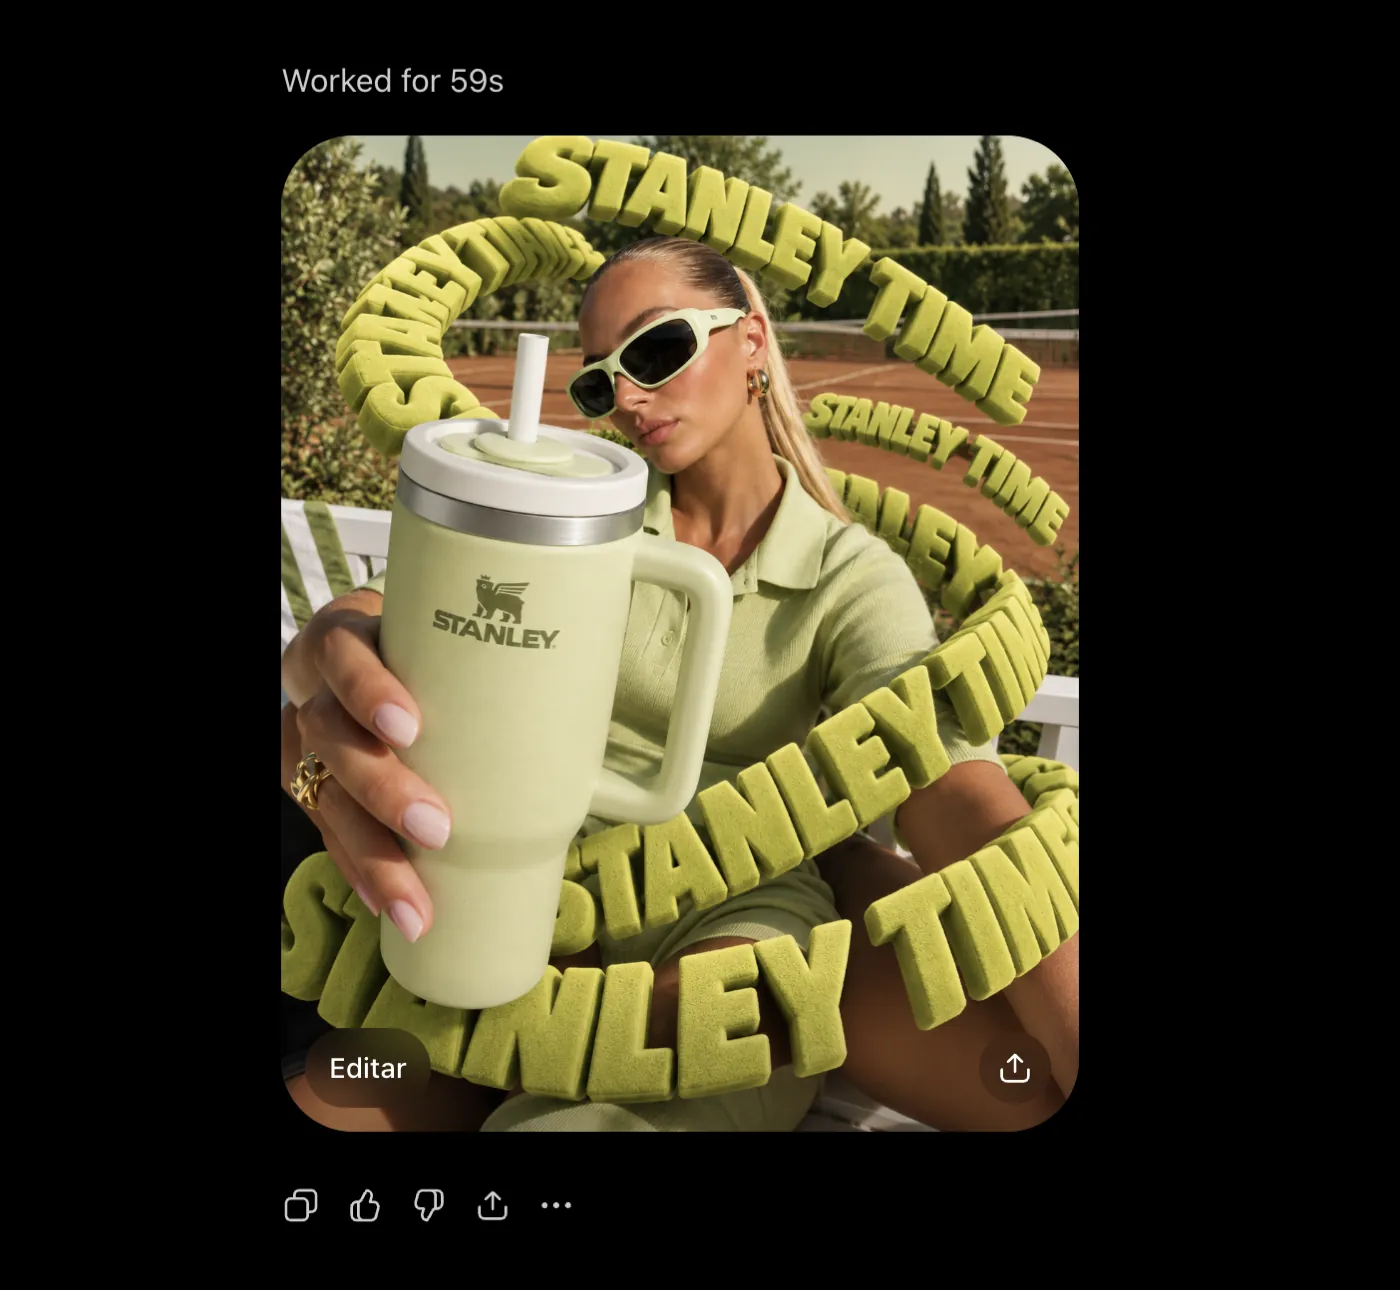
Fíjate en el detalle que lo cambia todo: el vaso mide 28 centímetros. Dar la medida real del producto es lo que hace que el modelo respete la escala en relación con el cuerpo. La segunda versión acertó la arcilla y la paleta, pero todavía falló en el tamaño, y creó extremidades de más.
Tercera ronda: anatomía y tamaño real
El tercer prompt es solo corrección, y es el que cierra la imagen:
el vaso tiene que ser 30% más grande todavía está pequeño y no está en tamaño real. tienes que poner atención al cuerpo de la chica, tiene que tener 2 piernas y una falda ligeramente corta, nada sensual porque las palabras la van a cubrir. solo cuida de no crear varias piernas y varios brazos como en la última imagen creada
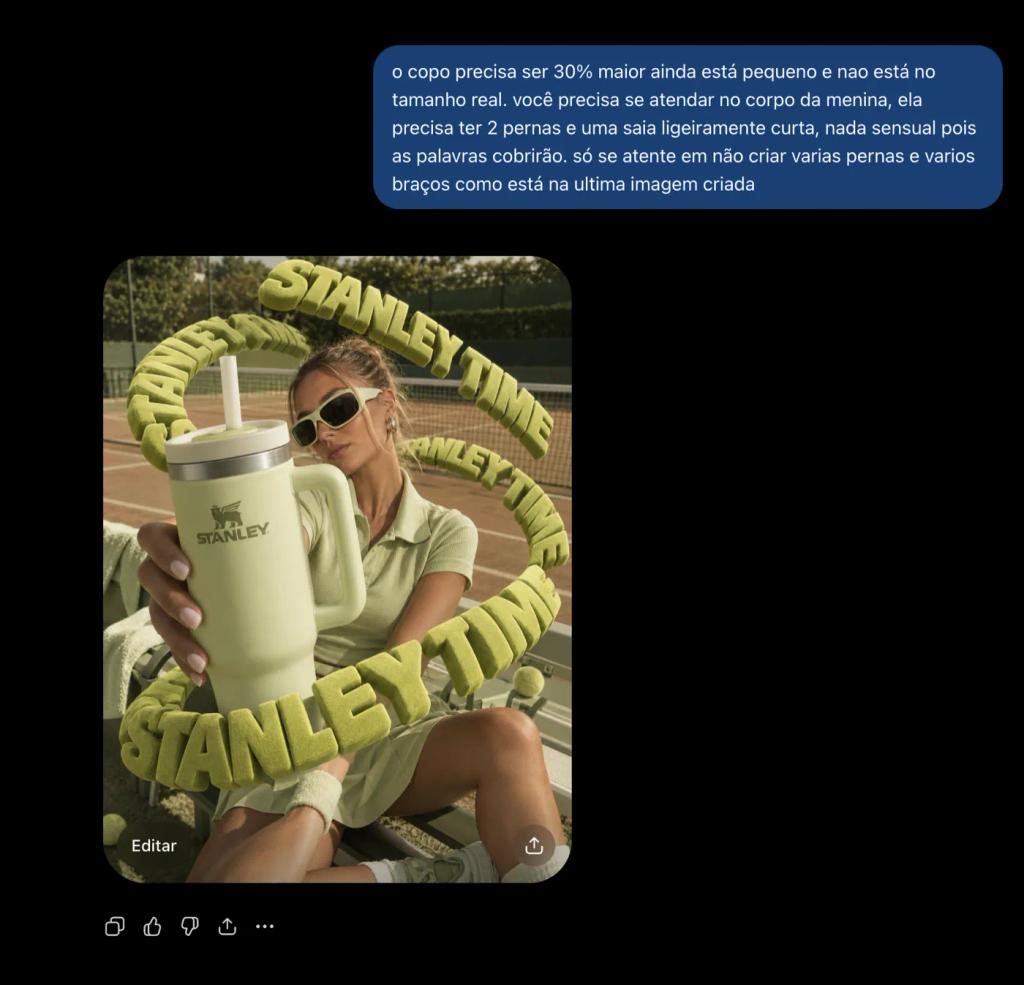
La tercera versión es la que fue al video. Costo total de esta etapa: menos del 1% de la cuota del plan Pro, aun con todas las rondas de retoque. Generar imágenes en ChatGPT es barato; lo caro es no saber qué pedir.
Paso 4: ¿cómo convertir la imagen en video con Seedance 2.5?
La imagen se convierte en video en Higgsfield, con Seedance 2.5 en modo imagen a video: subes la imagen base, escribes un prompt que describe acción y cámara, eliges duración, resolución y proporción, y el modelo genera el clip con audio. La toma de Stanley Time salió con 15 segundos, 1080p, proporción 3:4 y audio activado.
Según la página de Higgsfield sobre Seedance 2.5, publicada el 6 de agosto de 2026, el modelo de ByteDance genera hasta 30 segundos por clip, en 480p, 720p o 1080p, con ambiente, foley y música creados en la misma pasada del video. La misma página indica 90 créditos por 10 segundos en 1080p, lo que explica los 135 créditos de la toma de 15 segundos.
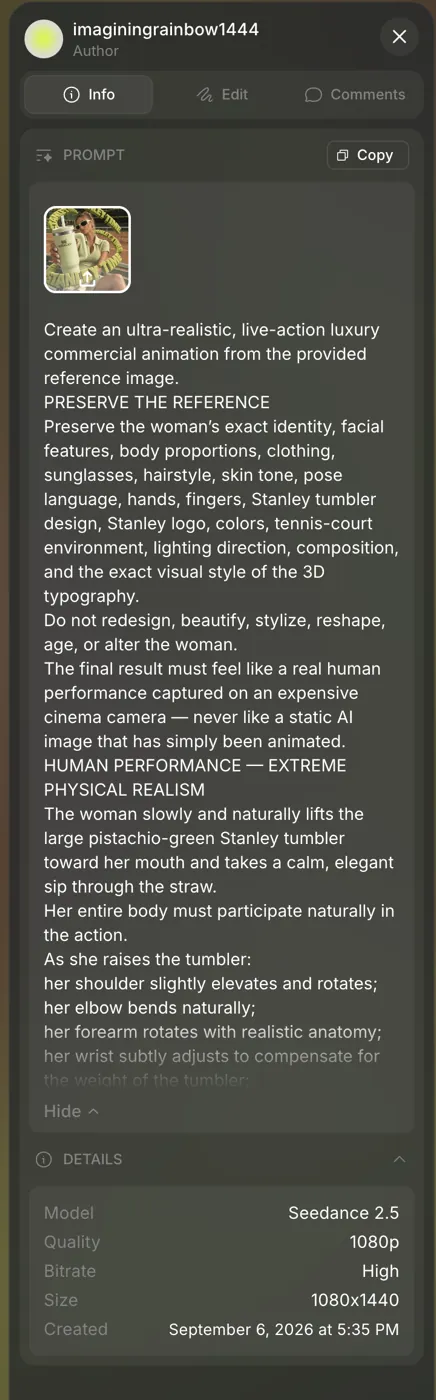
Si quieres reproducir el flujo, la cuenta es la misma que uso yo: crea tu cuenta en Higgsfield y busca Seedance 2.5 en la pestaña de video. Los enlaces a Higgsfield en este artículo son de afiliado: si te suscribes a través de ellos, Wama recibe una comisión, sin costo extra para ti.
El prompt del video es largo, en inglés, y está transcrito íntegro en la sección siguiente. Su lógica cabe en una frase: describir la física antes que la estética. Peso del vaso en la mano, respiración, cabello reaccionando al viento, sombra bajo la barbilla cambiando con la cabeza, letras 3D pasando delante y detrás del cuerpo con la oclusión correcta. Estética sin física se vuelve una imagen fija que se mueve.
De ese prompt salieron dos tomas de 15 segundos, a 135 créditos cada una. Una se descartó; la otra pasó al upscale. Antes, el mismo día, probé una toma horizontal de 10 segundos y un comercial solo con el producto, a partir de los renders de Blender. Los dos se quedaron en el archivo.
Anatomía del prompt de Seedance, bloque por bloque
El prompt de abajo es el que generó la toma final, transcrito íntegro. Las rayas del original se cambiaron por coma y dos puntos; nada más cambió. Cada bloque tiene una nota corta sobre lo que resuelve.
Preservar la referencia
Primero lo que no puede cambiar. Identidad, ropa, producto, ambiente y tipografía entran como cláusula fija antes de cualquier verbo de acción.
Create an ultra-realistic, live-action luxury commercial animation from the provided reference image.
PRESERVE THE REFERENCE
Preserve the woman’s exact identity, facial features, body proportions, clothing, sunglasses, hairstyle, skin tone, pose language, hands, fingers, Stanley tumbler design, Stanley logo, colors, tennis-court environment, lighting direction, composition, and the exact visual style of the 3D typography.
Do not redesign, beautify, stylize, reshape, age, or alter the woman.
The final result must feel like a real human performance captured on an expensive cinema camera, never like a static AI image that has simply been animated.
Actuación humana
La acción es una sola: levantar el vaso y beber. El bloque describe la cadena de músculos y el contrapeso del cuerpo, porque un brazo aislado moviéndose es el error más común de una imagen animada.
HUMAN PERFORMANCE: EXTREME PHYSICAL REALISM
The woman slowly and naturally lifts the large pistachio-green Stanley tumbler toward her mouth and takes a calm, elegant sip through the straw.
Her entire body must participate naturally in the action.
As she raises the tumbler:
her shoulder slightly elevates and rotates;
her elbow bends naturally;
her forearm rotates with realistic anatomy;
her wrist subtly adjusts to compensate for the weight of the tumbler;
her fingers maintain believable grip pressure around the cup;
her torso subtly shifts its center of gravity;
her upper body leans forward by a few degrees;
her opposite shoulder naturally counterbalances the movement.
There must be continuous, subtle secondary motion throughout the body rather than isolated arm animation.
Her chest, clothing and upper torso should respond very subtly to gravity, breathing and body acceleration, with physically believable soft-tissue inertia. Keep this extremely natural and restrained, no unnatural deformation.
Rostro, boca y el sorbo
El sorbo es el momento en que el video convence o delata que es IA. Por eso la descripción es muscular y pequeña: mejilla, mandíbula, garganta.
FACE, MOUTH AND DRINKING REALISM
The drinking action must be anatomically convincing.
When her lips make contact with the straw:
the lips gently close around it;
the corners of the mouth subtly contract;
the jaw slightly changes position;
the muscles around the mouth activate;
the cheeks very subtly draw inward from suction;
the area beside the nose and upper lip shows tiny muscular changes;
the skin around the mouth compresses naturally against the straw.
The cheeks must never collapse dramatically. The effect should be barely perceptible but realistic enough to communicate that she is actively drawing liquid through the straw.
During the sip, include tiny natural facial micro-movements:
subtle cheek tension;
minimal jaw movement;
slight movement of the chin;
tiny changes in nasolabial folds;
microscopic skin compression around the mouth;
natural movement of the lower face;
very subtle tension in the neck muscles.
After drinking, create a small realistic swallowing motion:
tiny movement around the throat;
subtle larynx movement;
slight relaxation of the cheeks and lips;
a nearly imperceptible exhale afterward.
Never freeze the face.
Even while remaining elegant and composed, her face must constantly exhibit tiny living micro-movements.
Cabeza, cuello y respiración
Cabeza y cuello acompañan el sorbo, y la sombra bajo la barbilla tiene que reaccionar al sol. La respiración es continua y casi invisible.
HEAD, NECK AND POSTURE
As she drinks, her head tilts naturally by a few degrees to meet the straw.
The neck bends and rotates anatomically with the head.
The chin position changes naturally during the movement.
Create realistic compression and stretching of the skin between the jawline, chin and neck.
A physically accurate soft shadow must form beneath her chin and jaw as her head position changes.
The shadow must dynamically respond to the sun direction and her motion rather than remaining painted onto the image.
BREATHING
Introduce very subtle breathing throughout the entire shot.
The upper chest, ribcage and shoulders should rise and fall almost imperceptibly.
The breathing must be visible only as natural human secondary motion, never exaggerated.
Her breathing should continue even while drinking, with a brief natural pause during the main sip followed by a soft release afterward.
Cabello, piel y tela
Tres materiales que delatan un video sintético cuando quedan rígidos: cabello, piel y tela. Cada uno recibe reglas de inercia y una lista de lo que no puede pasar.
HAIR PHYSICS
Her hair must never behave like a rigid object.
Individual strands and small groups of hair should respond naturally to:
head rotation;
body movement;
inertia;
gravity;
a very soft outdoor breeze.
When she slightly tilts or moves her head, loose strands should lag behind by a fraction of a second and then settle naturally.
Add extremely subtle random strand movement caused by the environment.
Hair must maintain its original haircut, volume, color and styling.
No morphing hairstyle, no disappearing hair, no artificial liquid-like movement.
SKIN REALISM
Skin must behave like real human skin under natural sunlight.
Preserve:
pores;
peach fuzz;
subtle skin translucency;
natural variations in skin tone;
tiny facial texture;
realistic specular response;
subtle subsurface scattering.
As facial muscles move, skin texture must remain attached to the anatomy rather than sliding or morphing.
Avoid plastic CGI skin, excessive smoothing or beauty-filter appearance.
CLOTHING AND SOFT-TISSUE PHYSICS
Fabric must react naturally to movement.
Create subtle fabric tension and relaxation around:
shoulders;
upper torso;
waist;
hips;
arms.
The fabric should slightly stretch, fold and settle as her posture changes.
Her body should display extremely subtle physically believable soft-tissue secondary motion caused purely by gravity, breathing and momentum.
Keep everything tasteful, restrained and realistic.
Luz y sombra
Las sombras de contacto cambian con la postura; la luz plana en el rostro está prohibida. Es el bloque que impide que la escena parezca un recorte pegado sobre un fondo.
LIGHTING AND SHADOW INTERACTION
Lighting must behave dynamically as her body moves.
Create realistic contact shadows and self-shadowing:
beneath the chin;
beneath the jaw;
between the neck and shoulders;
beneath the chest and natural clothing folds;
beneath the arms;
between the hand and Stanley tumbler;
beneath the tumbler when it approaches the body.
These shadows should shift naturally as her posture changes.
Maintain premium golden outdoor sunlight with believable directional light, soft fill from the environment and realistic global illumination.
Avoid flat facial lighting.
The face should retain dimensionality with gentle light falloff across the cheeks, jaw and neck.
El vaso como objeto rígido
El producto es el héroe y, al mismo tiempo, el punto más frágil: vaso que se derrite, asa que desaparece y logo que cambia son los defectos clásicos de un video generado. Todo se vuelve prohibición explícita.
STANLEY TUMBLER: ABSOLUTE GEOMETRIC CONSISTENCY
The Stanley tumbler is a hero product.
It must remain perfectly solid, rigid and geometrically consistent during the entire shot.
Preserve exactly:
tumbler shape;
dimensions;
handle;
lid;
straw;
Stanley branding;
material;
pistachio-green color.
No morphing.
No bending.
No shrinking.
No stretching.
No geometry changes.
No disappearing handle.
No duplicated straw.
No changing logo.
The Stanley logo must stay correctly positioned and readable whenever physically visible to the camera.
The tumbler should feel like a real weighted object.
Her hand and wrist must react to its weight.
Create physically accurate finger contact with the surface and realistic occlusion between fingers, handle and cup.
The straw remains rigid enough to behave like a real Stanley straw while maintaining realistic material properties.
Tipografía 3D
Las letras tienen masa, pasan delante y detrás del cuerpo, y la oclusión tiene que ser correcta. Lo que el bloque anterior hizo por el vaso, este lo hace por la tipografía.
3D TYPOGRAPHY: “STANLEY TIME”
At the same time, the large 3D words:
“STANLEY TIME”
slowly orbit around the woman in three-dimensional space.
Preserve exactly:
spelling;
font;
character proportions;
extrusion depth;
material;
pistachio color;
fuzzy velvet-like texture.
The letters behave like real solid objects with mass and depth.
Their motion follows elegant, smooth curved trajectories around the subject.
Different letters can travel with slightly different timing to produce dimensional parallax while remaining visually coordinated as one composition.
The letters must naturally pass both in front of and behind the woman.
Occlusion must be physically correct.
When a letter passes behind her:
the body must completely occlude the hidden portion.
When a letter passes in front:
it must cast believable subtle shadows and ambient occlusion where appropriate.
Never allow letters to:
melt;
deform;
change spelling;
duplicate;
disappear;
intersect unnaturally with her anatomy;
change font;
flatten into 2D graphics.
Cámara, foco y motion blur
Cámara de cine, lente de 50 mm, dolly-in lento con órbita de 5 grados y foco ajustado como lo haría un asistente de cámara. El motion blur es físico, nunca decorativo.
CAMERA
Premium cinematic advertising photography.
Camera system:
ARRI Alexa 35 aesthetic.
Lens:
high-end cinema prime lens around 50mm.
Movement:
begin with a very slow cinematic dolly-in while simultaneously performing an extremely gentle lateral orbit of approximately 5 degrees around the woman.
Add almost imperceptible heavy-camera micro-movement, similar to a real stabilized cinema rig operated by a human.
The camera must feel alive but expensive and controlled.
No obvious digital stabilization.
No robotic path.
No aggressive handheld shake.
Use realistic lens perspective.
Maintain the woman, her face and the Stanley tumbler as the hero subjects.
DEPTH OF FIELD
Use shallow but controlled cinematic depth of field.
Prioritize focus on:
the woman’s face;
her lips and straw during the drinking action;
the Stanley tumbler;
the nearest portions of the 3D typography.
The clay tennis court, distant foliage and background elements should fall naturally out of focus according to their physical distance from the focal plane.
Focus transitions should feel like an experienced 1st AC performing a subtle cinema focus pull.
Do not create artificial portrait-mode edge blur.
MOTION BLUR
Use physically plausible cinema motion blur.
Motion blur should appear naturally on:
moving hair strands;
hand motion;
tumbler movement;
orbiting letters;
subtle camera movement.
The woman’s facial features must remain readable and stable.
Do not smear the eyes, lips, fingers or Stanley logo.
Ambiente y calidad de imagen
Ambiente preservado con vida discreta, y una lista larga de cualidades de imagen: poros, reflejos, sombras de contacto, rango dinámico. El párrafo final fija la referencia: comercial de marca deportiva de alto presupuesto.
ENVIRONMENT
Maintain the original tennis-court environment.
Preserve:
clay court;
pistachio-green visual direction;
surrounding vegetation;
small amount of blue sky;
realistic outdoor atmosphere.
Add subtle environmental life:
extremely gentle foliage movement;
tiny breeze interaction;
natural variation in sunlight;
realistic atmospheric depth.
Do not introduce new objects or people.
CINEMATIC IMAGE QUALITY
The final animation must have:
hyper-realistic human skin,
visible pores,
peach fuzz,
realistic hair strands,
realistic fingernails,
correct anatomy,
physically accurate fabric,
natural soft-tissue motion,
realistic reflections,
accurate contact shadows,
subsurface scattering,
global illumination,
cinematic highlight roll-off,
realistic motion blur,
natural depth of field,
extremely high micro-detail,
premium commercial color science,
high dynamic range,
clean highlights,
rich but natural shadows.
Visual reference:
high-budget luxury sportswear commercial + premium Stanley product advertising + fashion editorial cinematography.
4K cinematic master quality.
The shot must look as if a real actress, real Stanley tumbler, real physical typography and real tennis location were filmed together practically with an ARRI Alexa 35.
Qué evitar
La lista negativa es tan larga como la positiva. Cierra con la prioridad que rige todo el prompt: credibilidad física humana.
ABSOLUTELY AVOID
AI-like facial morphing.
Frozen facial expressions.
Rigid hair.
Floating hair.
Rubber-like skin.
Plastic skin.
Beauty-filter skin.
Face identity changes.
Eye deformation.
Lip deformation.
Cheek deformation.
Overdone cheek suction.
Exaggerated body physics.
Exaggerated chest motion.
Body warping.
Breast or torso deformation.
Extra limbs.
Extra arms.
Extra hands.
Extra legs.
Extra fingers.
Missing fingers.
Fused fingers.
Changing hand anatomy.
Cup deformation.
Cup resizing.
Cup morphing.
Logo deformation.
Logo disappearance.
Straw duplication.
Changing tumbler geometry.
Typography morphing.
Misspelled text.
Melting letters.
Unnatural object intersections.
Static shadows attached to the original image.
Fake CGI lighting.
Robotic body movement.
Robotic camera movement.
Excessive slow motion.
Artificial digital sharpness.
Overprocessed HDR.
Every movement should contain subtle acceleration, deceleration, inertia, weight, muscle response and secondary motion.
Nothing should move independently without a physical cause.
The strongest priority is HUMAN PHYSICAL BELIEVABILITY.
It must feel observed rather than animated.
The viewer should believe this was captured as a real live-action Stanley commercial.
Paso 5: el upscale a 4K con Topaz Video
Seedance entrega 1080p, Instagram comprime, y el resultado en el celular pierde textura de piel y nitidez en las letras. El upscale existe para llegar con margen: la toma elegida pasó por Topaz Video dentro del propio Higgsfield y salió de 1080 por 1440 a 2880 por 3840 píxeles, por 51 créditos.
La integración viene de una alianza de 2025: según la cobertura de PetaPixel del 6 de agosto de 2025, Higgsfield empezó a ofrecer el upscale de video de Topaz Labs a 2K y 4K directo en el navegador, con modelos distintos para rostro, textura y contenido estilizado. Para una sola persona, eso elimina una etapa entera de software instalado.
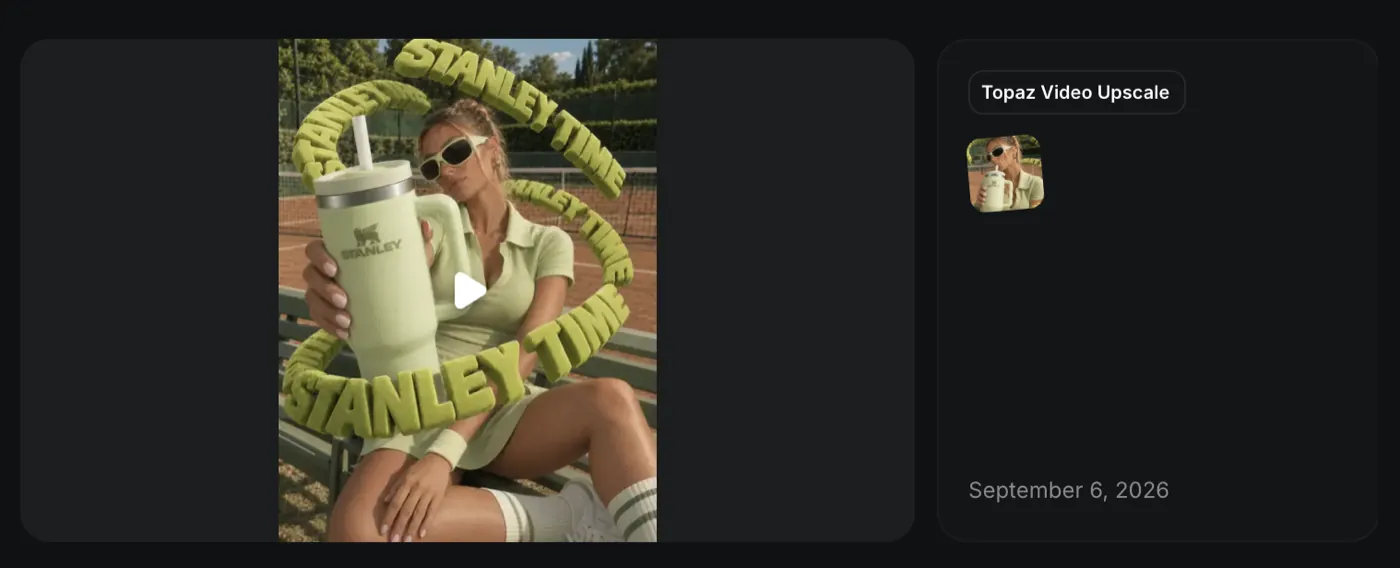
Es el mismo razonamiento de acabado que aplico al presentar un producto digital en video: la pieza tiene que llegar con calidad de sobra adonde se va a ver, porque la plataforma va a comprimirla. El upscale está en la misma cuenta: prueba el upscale de video de Higgsfield con un clip tuyo antes de decidir si vale la pena para tu producto.
¿Cuánto cuesta un video publicitario con IA?
El video Stanley Time costó 186 créditos de Higgsfield en la toma que salió al aire: 135 de Seedance 2.5 y 51 de Topaz Video, cerca de US$ 9 con la conversión de US$ 0,05 por crédito que el propio Higgsfield usa en la página del modelo. Sumando el modelo 3D y las imágenes, el consumo en ChatGPT quedó cerca del 12% de la cuota mensual del plan Pro. Sin contar las horas de quien dirige.
Etapa | Herramienta | Qué consumió |
|---|---|---|
Modelo 3D del vaso | GPT-6 Astra operando Blender | cerca del 11% de la cuota mensual del plan Pro de ChatGPT |
Referencia visual | cero | |
Imagen base, tres rondas | ChatGPT, generador de imágenes | menos del 1% de la cuota mensual |
Video de 15 segundos en 1080p | Higgsfield, Seedance 2.5 | 135 créditos por toma |
Upscale a 2880 por 3840 | Higgsfield, Topaz Video | 51 créditos |
Total en Higgsfield, toma final y upscale | 186 créditos, cerca de US$ 9 |
La cuenta con lo que se descartó
La cuenta honesta incluye lo que se descartó. Contando las tomas del mismo día que no salieron al aire, dos de 10 segundos y una segunda toma de 15, el consumo en Higgsfield sube a 501 créditos, cerca de US$ 25. El registro de la cuenta muestra la primera toma a las 16:36 y el upscale a las 19:56 del 6 de septiembre de 2026.
Lo que la tabla no muestra es la etapa que más pesa: la dirección. Elegir la referencia, saber que el vaso mide 28 centímetros, darse cuenta de que la modelo ganó una pierna de más, decidir que la paleta es 90% pistache. Ese es el trabajo, y es lo que separa un video de campaña de un clip generado. Es el mismo criterio que uso con IA en el desarrollo: la herramienta se encarga de lo repetitivo, la persona responde por la decisión. Y es la misma regla que uso para explicar cuánto cuesta un sitio web profesional: el valor está en la decisión, no en la herramienta.
Si tu duda es si ese costo se paga para tu producto, el camino más barato es hacer la cuenta con un clip real: mira los planes de Higgsfield, genera 10 segundos en 720p y compáralo con el presupuesto de un día de producción.
Errores que cuestan créditos
Cada punto de abajo costó créditos o una ronda en este proyecto. El orden es el orden en que aparecieron.
No dar la medida del producto. El vaso salió pequeño dos veces. Solo respetó la escala cuando el prompt dijo 28 centímetros y pidió 30% más.
Corregir varias cosas en la misma ronda. Mayúsculas, fondo y paleta juntos salieron bien; tamaño y anatomía juntos, no. Una corrección por ronda es más barato de lo que parece.
Dejar el color suelto. Mientras la paleta no se fijó en 90% pistache monocromático, cada versión tiraba hacia un verde distinto.
Animar antes de aprobar la imagen. La imagen cuesta casi nada; la toma de video cuesta 135 créditos. Todo defecto de anatomía que pasa al video queda animado durante 15 segundos.
No fijar la geometría del producto en el prompt de video. Sin el bloque de consistencia, el vaso se derrite, el asa desaparece y el logotipo cambia. La mitad del prompt existe para impedirlo.
Generar directo en 1080p con audio. El centro de ayuda de Higgsfield recomienda iterar en 720p y activar el audio solo en la pasada final. Lo ignoré y pagué dos tomas de 15 segundos en 1080p.
Hacer upscale de una toma no aprobada. Son 51 créditos que solo valen sobre la toma definitiva. Aprueba en 1080p y después sube la resolución.
Antes de gastar el primer crédito, vale la pena tener esta lista abierta al lado: abre tu cuenta en Higgsfield y empieza por un clip corto y barato, solo para ver cómo se comporta tu producto en movimiento.
¿Qué cambia esto para una marca?
Para una marca, un video publicitario con IA cambia el costo de experimentar, no la necesidad de dirección. Una pieza de prueba que antes exigía set, modelo y productora sale de un escritorio con una persona y algunas decenas de dólares en créditos. Lo que sigue siendo caro es acertar: referencia, escala, color, anatomía y el criterio para descartar lo que no sirve.
Hay límites que una marca tiene que conocer antes de encargarlo. La identidad de una modelo generada no es un rostro contratado, y la consistencia entre piezas exige cuidado. Una marca registrada de terceros, como Stanley en este estudio, no puede salir al mercado sin autorización. Y el video es solo la pieza: necesita un lugar donde trabajar, que casi siempre es la página donde ese video va a convertir o un perfil que la marca sostiene con constancia.
En Wama, este flujo entra en el mismo lugar donde la IA ya entra en nuestro proceso: acelerar la producción sin quitar la decisión de la mesa. Lo muestro en agencias que ya usan IA en la producción de sitios web y en lo que Wama entrega como agencia Framer. El video del producto, el sitio web y la identidad son partes del mismo proyecto, y la dirección que hizo que el vaso midiera 28 centímetros es la misma que decide qué entra en la home.
El video terminado entra en el mismo pipeline que publica todo lo demás: la automatización de publicaciones con Zernio lleva cada pieza a las redes en el horario correcto, después de la aprobación.
Preguntas frecuentes
¿Necesito saber Blender para hacer un video así?
No para empezar. GPT-6 Astra construyó el vaso dentro de Blender a partir del prompt; lo que hice yo fue revisar proporciones y el render. Saber lo básico ayuda a corregir rápido, y es lo que evita aceptar un modelo chueco por no ver el error. Sin producto en 3D, una buena foto del producto también sirve como referencia.
¿Higgsfield es de pago? ¿Cuánto cuesta generar un video?
Higgsfield funciona con créditos incluidos en planes mensuales. Según la página oficial de Seedance 2.5, 10 segundos en 1080p cuestan 90 créditos, y la toma de 15 segundos de este artículo costó 135. El upscale con Topaz costó 51. El precio aparece antes de confirmar cada generación, y puedes probar con un clip corto en Higgsfield sin sorpresas.
¿Seedance 2.5 genera audio junto con el video?
Sí. Según la página de Higgsfield sobre el modelo, Seedance 2.5 crea ambiente, foley y música en la misma pasada en que genera la imagen, en clips de hasta 30 segundos. En Stanley Time el audio quedó activado en la toma final. Para iterar barato, la recomendación de Higgsfield es generar en 720p y activar el audio solo en la pasada final.
¿Puedo usar la marca de un producto que no es mío en un video con IA?
Para estudio y portafolio, identificando claramente que la pieza no es oficial, es lo que hice aquí. Para pautarlo como anuncio, no: la marca registrada, el logotipo y el diseño del producto pertenecen al dueño de la marca, y el uso comercial exige autorización. Si el producto es tuyo, el mismo flujo vale sin esa restricción. Esto no es asesoría legal.
¿Cuánto tiempo toma hacer un video publicitario con IA?
La parte de video cupo en una tarde: el registro de mi cuenta en Higgsfield muestra la primera toma a las 16:36 y el upscale a las 19:56 del 6 de septiembre de 2026. El modelo 3D y las rondas de imagen vinieron antes. El tiempo que no aparece en ningún registro es el de mirar cada versión y decidir qué corregir.
Un video generado muestra el producto; lo que sostiene la marca es el conjunto: sitio web, identidad y piezas con la misma dirección. En Wama, diseño y desarrollo eso de punta a punta, del diseño a la publicación, con IA donde acelera y criterio donde ella no decide. Si tu marca necesita un sitio web a la altura de lo que vas a mostrar en él, conoce el trabajo de Wama.



